Domain ssbb.de kaufen?
Wir ziehen mit dem Projekt
ssbb.de um.
Sind Sie am Kauf der Domain
ssbb.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain ssbb.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Braun, Jutta: Wettkampf der SystemeWettkampf der Systeme , Unter dem Einfluss der deutschen Teilung entwickelten sich sowohl der Breiten- als auch der Spitzensport unter verschiedenen Vorzeichen. Während der Sport im Westen vor allem im Vereinswesen verankert war, wurde er im Osten staatlich organisiert. Im Rahmen internationaler Großereignisse wie den Olympischen Spielen oder Weltmeisterschaften trafen beide Sportsysteme aufeinander und wurden zu Stellvertretern im Wettbewerb der politischen Systeme. Jutta Braun beschreibt die Entwicklungen beiderseits der Mauer bis hin zum gemeinsamen 'Lauf' in die Einheit 1989/1990. Sie analysiert die Rolle herausragender Sportidole und legendärer Begegnungen wie der Fußball-WM 1974, beleuchtet den Schattenbereich des Dopings mit seinen jeweils spezifischen Ausprägungen und nimmt zugleich die Rolle der Fans und ihrer Subkultur in den Blick. , Kontrollventile > Ventile & Ventilsteuerungsteile , Erscheinungsjahr: 20240618, Produktform: Leinen, Autoren: Braun, Jutta, Redaktion: Creuzberger, Stefan~Geppert, Dominik~Hoffmann, Dierk, Seitenzahl/Blattzahl: 192, Abbildungen: 30 s/w-Abbildungen, Keyword: Breitensport; Bundesrepublik; DDR; Doping; Olympische Spiele; Sport; Sportgeschichte; Vereinssport; Weltmeisterschaft; Wettbewerb; Wiedervereinigung; deutsche Teilung, Fachschema: DDR~Deutschland / DDR~Deutschland / Westdeutschland~Westdeutschland~Bundesrepublik Deutschland~Europa / Geschichte, Kulturgeschichte~Kalter Krieg~Krieg / Kalter Krieg~Sport / Geschichte, Fachkategorie: Europäische Geschichte~Geschichte des Sports, Warengruppe: HC/Zeitgeschichte/Politik (ab 1949), UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 216, Breite: 141, Höhe: 21, Gewicht: 347, Produktform: Gebunden, Genre: Geisteswissenschaften/Kunst/Musik,22,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter



-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **

Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
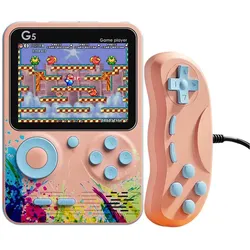
VR Shinecon Konsole Emulator 400 Spiele mit Multiplayer-Controller, Retro Gaming, RotDie Sup-Modell-Spielkonsole in Rot ermöglicht es Ihnen und Ihrem Kind, in die mythischen Spiele einzutauchen, die Ihre Kindheit geprägt haben. Sie bietet fast 400 klassische Spiele wie Mario, Street Fighter, Bomberman und mehr. Der wiederaufladbare 350 mAh Akku hält etwa 3 Stunden. Eigenschaften und Produktspezifikationen: - 400 enthaltene Spiele - Aufladung über Micro-USB-Kabel (im Lieferumfang enthalten) - 2,4-Zoll-HD-Farbdisplay mit optimaler Grafikdarstellung - Ausgezeichnete Akkulaufzeit: 3 Stunden.31,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
VR Shinecon Konsole mit 500 Spiele-Emulator und Multiplayer-Controller Modell StreetArt, Retro Gaming, Rosa, PinkDie pfirsichrosa Spielkonsole StreetArt ermöglicht es Ihnen und Ihrem Kind, in die mythischen Spiele einzutauchen, die Ihre Kindheit geprägt haben. Sie bietet fast 500 klassische Spiele. Der wiederaufladbare 1000mAh Akku reicht für ca. 7 Stunden Spielzeit. Die Konsole wird mit einem kabelgebundenen Controller verkauft und verfügt über einen AV-Ausgang (Kabel im Lieferumfang enthalten), sodass sie an Ihren Fernseher angeschlossen werden kann.. Eigenschaften und Produktmerkmale: 500 Anzahl der enthaltenen Spiele. Aufladen über Micro-USB-Kabel (im Lieferumfang enthalten). 3-Zoll-HD-Farbbildschirm mit optimaler GrafikwiedergabeLange Akkulaufzeit: 7 Stunden.42,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Braun, Jutta: Wettkampf der SystemeWettkampf der Systeme , Unter dem Einfluss der deutschen Teilung entwickelten sich sowohl der Breiten- als auch der Spitzensport unter verschiedenen Vorzeichen. Während der Sport im Westen vor allem im Vereinswesen verankert war, wurde er im Osten staatlich organisiert. Im Rahmen internationaler Großereignisse wie den Olympischen Spielen oder Weltmeisterschaften trafen beide Sportsysteme aufeinander und wurden zu Stellvertretern im Wettbewerb der politischen Systeme. Jutta Braun beschreibt die Entwicklungen beiderseits der Mauer bis hin zum gemeinsamen 'Lauf' in die Einheit 1989/1990. Sie analysiert die Rolle herausragender Sportidole und legendärer Begegnungen wie der Fußball-WM 1974, beleuchtet den Schattenbereich des Dopings mit seinen jeweils spezifischen Ausprägungen und nimmt zugleich die Rolle der Fans und ihrer Subkultur in den Blick. , Kontrollventile > Ventile & Ventilsteuerungsteile , Erscheinungsjahr: 20240618, Produktform: Leinen, Autoren: Braun, Jutta, Redaktion: Creuzberger, Stefan~Geppert, Dominik~Hoffmann, Dierk, Seitenzahl/Blattzahl: 192, Abbildungen: 30 s/w-Abbildungen, Keyword: Breitensport; Bundesrepublik; DDR; Doping; Olympische Spiele; Sport; Sportgeschichte; Vereinssport; Weltmeisterschaft; Wettbewerb; Wiedervereinigung; deutsche Teilung, Fachschema: DDR~Deutschland / DDR~Deutschland / Westdeutschland~Westdeutschland~Bundesrepublik Deutschland~Europa / Geschichte, Kulturgeschichte~Kalter Krieg~Krieg / Kalter Krieg~Sport / Geschichte, Fachkategorie: Europäische Geschichte~Geschichte des Sports, Warengruppe: HC/Zeitgeschichte/Politik (ab 1949), UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 216, Breite: 141, Höhe: 21, Gewicht: 347, Produktform: Gebunden, Genre: Geisteswissenschaften/Kunst/Musik,22,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.